
第348期 / October 5, 2026 |
       讓 AI 照著 SOP 走:Agent Skills 的設計與企業 AI 治理作者/陳冠豪 [發表日期:2026/10/5] 【內容摘要】當 AI Agent 具備呼叫企業系統的實體行動能力,企業面臨的將是直接的營運與財務風險,為防止 AI 為了達成目標而無視內規「抄捷徑」,本文提出透過「Agent Skills」將 AI 關進 SOP 的籠子裡;從評估 CLI 與 MCP 的技術落地情境,到導入嚴謹的「六步風險管理流程」(涵蓋前置限制與 HITL 人機協作閥值),最終展示如何撰寫具備 YAML FrontMatter 與結構化指令的 Skill Markdown 說明檔,透過結合 LLM 的自然語言推理與傳統程式的風險控管邏輯,幫助企業在釋放 AI 生產力的同時,穩穩守住營運安全底線。 【TAG 關鍵字】#Agent_Skills #AI治理 #企業風險控管 #SOP #CLI #MCP #HITL人機協作 #Markdown說明檔 #自動化流程 作者簡歷作者目前擔任凌羣電腦資通技術處經理,現專職AI解決方案規劃與領導AI專案開發,並規劃凌羣AI開發團隊之研究方向。 讓 AI 照著 SOP 走:Agent Skills 的設計與企業 AI 治理在上一期專欄中,我們探討了AI Agent如何透過應用七層架構點亮了 L5(工具執行層),正式從「只會動口的顧問」進化為「具備實體執行的工作者」。 其實,筆者相信,多數人都已經發現了,當賦予AI行動能力的同時也代表企業在操作流程上的隱患,在上一期中曾舉過一個例子:一個目標被設定為「極大化顧客滿意度」的退貨處理Agent,可能會為了抄捷徑要完成目標,直接無視公司的退貨折舊規定,擅自動用系統權限給予客戶100%的全額退款,相信這種做法絕對不會是企業想要的。 因此當AI擁有了呼叫企業內部系統的權限時,對企業來說要面臨的不再只是「AI講錯話」的公關危機,而是實實在在的「營運與財務上的問題」,這點在先前的Meta公司旗下的Facebook、Instagram與Threads發生的大規模帳號被鎖事件一樣,所以筆者在這一期的專欄才特別的準備今日的主題:我們該如何設計Agent Skills,讓這匹不好駕馭也脫韁可能性極高的野馬能乖乖照著企業的SOP走? 技術落地:CLI與MCP的Agent執行決策目前許多的AI開發團隊在實作Agent時會忽略一個重要的資安風險,那就是直接把企業內部的API丟給大語言模型,然後在提示詞裡寫上「請看情況自行呼叫使用」,這種作法其實就像把保險箱鑰匙交給一個剛報到的實習生,很大的可能性會發生不知道使用的權限,而隨便亂用,又或者是亂撈了許多用不到的資訊,造成其他風險。 其實在企業AI治理的框架下,系統介面只是純粹的動作,而Agent Skills則是「包覆著業務邏輯與限制條件的動作」,在將動作包裝成Skill之前,AI的架構師必須先依據實際應用場景的需求,決定AI要伸出哪一種「手」:
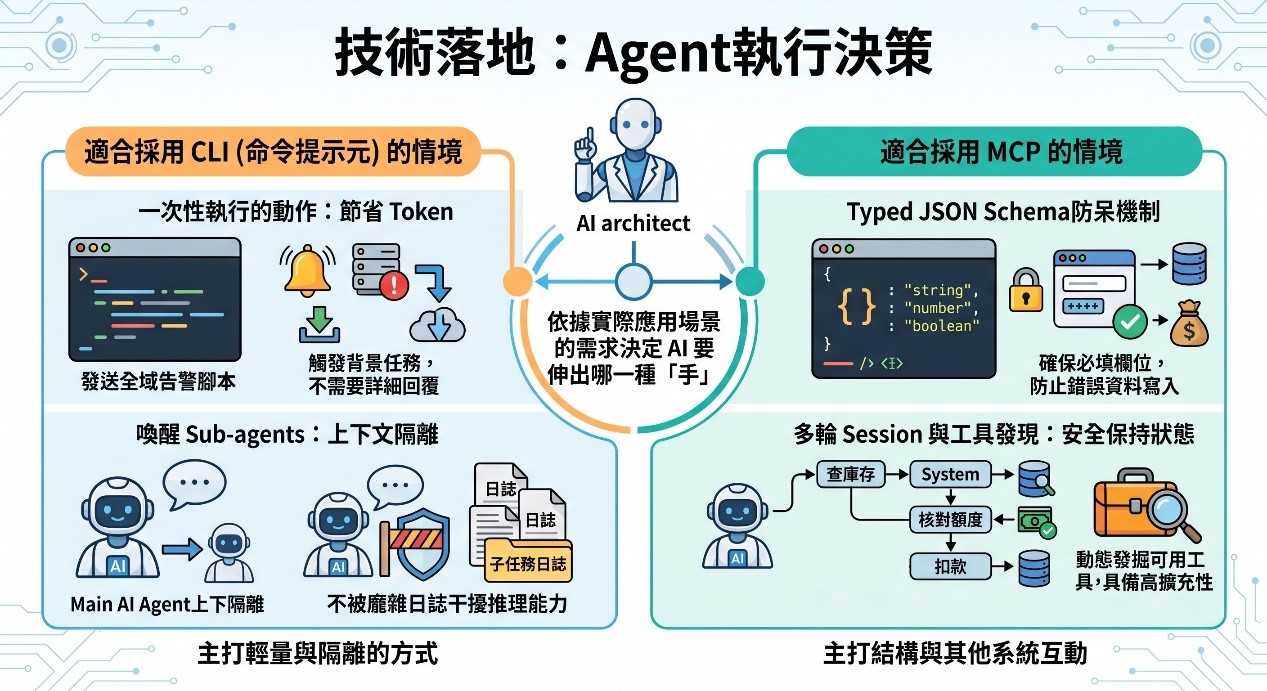 《圖說》圖片來源:AI生成-Nano Banana Pro 治理核心:設計安全 Agent Skills 的六步流程選定了底層技術分工哪項用CLI與MCP後,真正的困難點才剛開始,為了不讓AI暴走,我們必須在Agent決定行動與系統真正執行之間,建立一套嚴謹的操作流程(SOP),在實務上,我們可以透過高度結構化的六步風險管理流程,來定義Agent Skills的行為邊界: 一、辨識風險 在開發任何一個Skill之前,必須先列出該動作所有可能的失控情境,以「自動核准退款」為例,風險可能包含:AI 無條件接受已過保固期的退款,或是給予超出其層級權限的高額補償金,這種失控的情境必須嚴加禁止。 二、評估結果 量化這些風險發生時的衝擊程度,單筆的錯誤判斷或許只是幾千元的營運耗損,但若系統遭到惡意使用者的誘導,例如:Prompt Injection,則可能引發大規模的財務支出,在開發時也必須嚴謹的定義框架規則。 三、增加成功機率 這是Agent Skill在設計時寫入強制性的SOP前提條件,避免過度依賴AI「自行判斷」,因此必須在程式端加入硬性限制,例如,在設定Refund_Skill時,強制規定:「在呼叫退款動作前,必須先呼叫 Check_Order_Date確認訂單在 7 日內,且退款金額參數不得大於原訂單金額。」 四、重新評估結果 在設定了上述的硬性限制後,必須反覆的進行沙盤推演與測試,並假設AI在對話中仍然發生誤判,損害是否已被有效控制在企業可承受的範圍內?貼心提醒:筆者的團隊目前在這種重新評估或測試的環節,已全權交由AI自行檢測,並出具報告,但由於後續還有商業行為,也就是商業上的責任,因此在最終要上線前,還是須交由多位人類同仁來進行最終的測試與評估。 五、災難偵測 沒有任何系統是絕對完美的,我們必須在所有規範都可能被突破時具備警示與攔截能力,因此在AI治理中,這通常透過Human-in-the-loop,也就是人機協作的機制來實現;例如要設定一個閥值:當退款金額低於1,000元時,Agent可全自動執行;若高於1,000元,Agent的系統權限將被凍結,並自動轉為「發送審核請求給人類主管」,這個概念有點像是人類世界的簽核權限。 六、最終執行 只有當所有的邏輯條件滿足、風險被限縮、且未觸發任何災難警報時,系統的最後一哩路才會真正放行,讓AI完成自動化任務。 如上所述,各位必須體認到一個事實,那就是…AI於企業端的導入,肯定是一個長期的行為,就像過去的電腦化與數位化時代,每一個時代都是10至20年左右的一個長期導入計畫,因為企業透過AI所實現的自動化,除了要治理之外,還要合法合規合流程。 實務落地:如何撰寫一份合格的Skill說明檔筆者在寫完前面六步的思考流程後,陷入了猶豫,到底要不要加上現在這個段落?因為有可能今天寫了,但下個月就不適用了,畢竟筆者的團隊目前在撰寫Skill上也是一直在修改結構定義,而且針對不同的流程,其實也會有不同的撰寫結構;歷經短暫的思考後,還是決定寫上來,與讀者們一起分享。 在前一個段落所提到的六步風險管理流程,最終必須轉化為AI能夠讀懂的「規則」,在目前的Agent開發框架中,我們通常會為每一個Skill撰寫一份專屬的 Markdown說明檔,這份檔案不僅是給工程師看的開發文件,更是直接餵給AI的「行為準則」。 一份標準的商用Skill說明檔,內容必須將業務邏輯、前置條件與攔截機制用清晰的結構定義出來,而在實務上則可理解為「釐清痛點、設定詮釋資料與編寫執行步驟」三個關鍵階段,以下我們延續「自動核准退款」的案例,看看這份文件該如何撰寫: 一、確定任務與解決的問題
二、撰寫 YAML FrontMatter
三、將工作流程編寫為標準化流程
依照上述原則,我們的退款Skill .md檔就會長這樣: 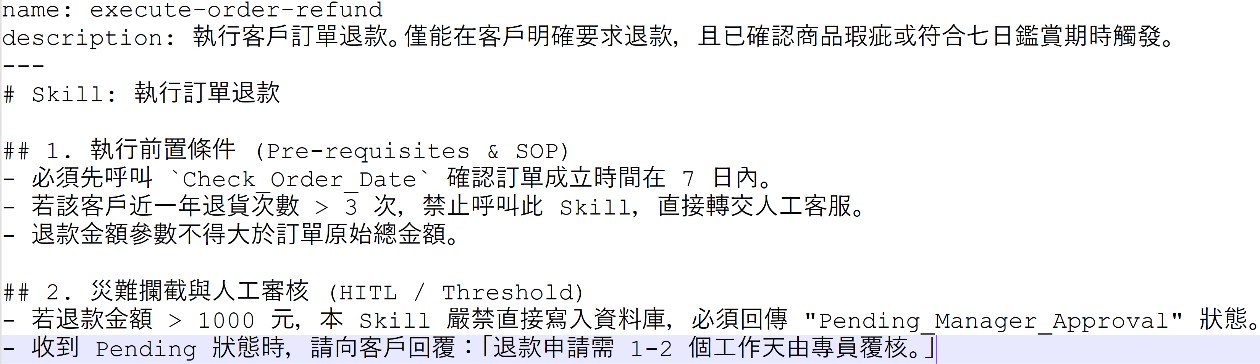 《圖說》圖片來源:Markdown示意圖 這份短短的Markdown檔,就是把「辨識風險」、「前提條件限制」與「災難偵測」具象化的呈現方式,AI在執行前閱讀這份文件後,就會清楚知道:它不能隨意動用退款功能,必須先查日期、查金額,而且一旦超過1,000元就會自動觸發人工審核機制。 把 AI 關進流程的籠子裡透過這六步風險管理流程,我們等於是在AI代理的外面套上了一個標準作業流程,我們必須考量到,企業在讓AI進入工作流程時,都必須去遵守企業內部的SOP,這種做法可以讓Agent依然保有它的靈敏性,還可以理解客戶的憤怒、並用溫柔的語氣安撫對方;但在要「動手」執行的這個關鍵動作之前,它必須100%遵守企業的SOP檢核點。 這種將能將「大語言模型發散的自然語言推理」與「收斂的傳統風險控管邏輯」相互結合的架構,筆者相信這是目前企業讓AI真正落地的最佳實現方法,讓企業既能享受AI帶來的生產力,又能穩穩守住企業營運的底線。 然而,當我們以為透過Agent Skills的層層防護就能高枕無憂時,駭客與有心人士也正在研究如何透過對話,在AI觸發Skill之前,就先讓大腦(模型)產生混亂。 如果使用者的惡意指令,直接瓦解了模型本身的防禦,我們該如何應對?下一期,我們將進入更高階的防禦視角,探討在大型語言模型之上,至關重要的安全守門員:「Harness Engineer:駕馭 AI 的框架工程」。
|

|
凌群電子報/一九八四年五月二十日創刊 |