|
|
Harness Engineering:駕馭AI的框架工程作者/陳冠豪 【內容摘要】 當企業 AI 應用從單一動作的 Agent Skills,走向跨部門、多系統與長時間運行的複雜流程時,開發團隊將面臨狀態中斷、資源衝突與系統失控的嚴峻挑戰。本文深入剖析 AI 應用開發的第三階段核心——「Harness Engineering(駕馭工程)」。透過 Agent = Model + Harness 的架構思維,詳解如何建立持久化的任務狀態管理、獨立於模型外的工具權限隔離、多 Agent 協作的資源鎖定(Resource Locking)機制,以及防範無限迴圈與 Prompt Injection 的系統級護欄。駕馭工程的核心不在於期待 AI 永遠不犯錯,而是打造一套高可靠性的基礎設施,確保 AI 在犯錯或異常發生時,風險依然被嚴格控制在企業可承受的邊界之內。 【TAG 關鍵字】#Harness_Engineering #駕馭工程 #AI_Agent #狀態管理 #多Agent協作 #工具執行控制 #權限隔離 #系統防護 #非紅供應鏈 #企業AI架構 作者簡介作者目前擔任凌羣電腦資通技術處經理,現專職AI解決方案規劃與領導AI專案開發,並規劃凌羣AI開發團隊之研究方向。從Agent Skills到Harness Engineering:企業AI開發的下一道難題在前面兩期專欄中,我們探討了AI Agent的崛起:第8篇(九月號第347期【AI Agent:從「對話」進化到「行動」】)談到透過CLI與MCP賦予AI執行的能力,讓它能操作系統;第9篇(十月號第348期【讓 AI 照著 SOP 走:Agent Skills 的設計與企業 AI 治理】),則說明了如何透過六步風險管理與撰寫Skill說明檔,為AI的每一個動作套上SOP檢核點;很多開發團隊做到這一步,看著AI能安分地執行單一退款或查詢動作,就以為大功告成了,然而,當企業準備將十幾個不同的Agent投入到複雜的跨部門流程時,真正的困難階段才正要開始。 因為要讓AI執行一個動作,與讓AI長時間保持運行、安全與穩定的完成企業任務,則是完全不同層次的問題,我們試想一下,當企業內部的AI應用開始處理跨部門工單、非同步任務、多系統整合與高風險操作時,我們必須面對一個現實:模型可能判斷錯誤,工具可能執行失敗,網路可能中斷,任務可能重複執行,甚至整個系統可能在執行到一半時突然停止;相信講到這裡,大家就可以知道這些問題,並不是再多寫幾行提示詞或Skill規則就能解決的。 如果說LLM是一匹具有強大能力、卻無法完全預測他行徑方向的野馬,那麼Agent Skills則像是教它如何完成特定工作的訓練規範,再到Harness Engineering則是建立一整套能夠控制行動、管理狀態、處理故障並確保安全的駕馭系統。 這就是我們今天要探討的AI應用開發的第三階段核心:Harness Engineering也稱為駕馭工程,它不只是讓AI能夠執行任務,而是讓整個系統在AI可能犯錯、工具可能失敗、流程可能中斷的情況下,仍然能夠安全、可控且可恢復地運作;相信這點也是現在每個AI開發團隊花最多時間在琢磨的技術;在正式進入今天的主題之前,筆者先將過去兩篇的彙整如下表,供讀者們更容易理解近期專欄之關聯性與實作時的順序: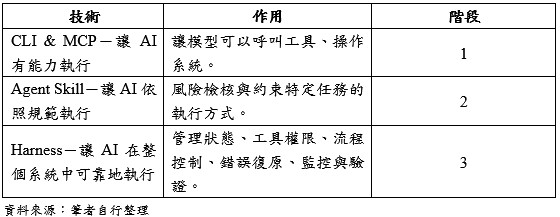
Agent = Model + Harness:駕馭工程的版圖在目前的AI應用開發業界中最廣泛且又經典的「架構公式」:Agent = Model + Harness,請注意這裡是用架構公式,這個公式並不是嚴格統一的業界標準定義,而是一種方便理解Agent系統的簡化方式。 先以比較容易理解的方式來比喻,如果說LLM是強大的「引擎」,那麼Harness就是包裹著引擎的車體結構,包含了方向盤、煞車系統與安全氣囊等各項確保車輛能持續運作的機制;再回到AI的部份,模型負責理解問題、產生判斷與規劃行動;而Harness的概念則是負責將這些判斷轉化為受控的執行流程,並確保每個動作都符合企業執行的條件。 對應到我們之前談過的AI七層架構:
記憶與狀態管理:讓 AI 記得任務進度,更知道事情做到哪裡在企業流程中,一項任務往往不是一次請求就能完成,而是包含多輪對話、長時間等待與跨系統協作的非同步任務,例如,主Agent派出子Agent查核客戶信用,子Agent可能需要十分鐘才回傳結果,那在這段時間內,主Agent依舊要保留原本的任務目標、已完成的步驟,以及接下來需要執行的工作,不過要求還只是最基本的。 筆者認為在AI應用開發中真正困難的是…如果系統在等待過程中突然中斷,重新啟動後,則Harness就是必須知道哪些工作已經完成、哪些工作仍在執行,以及哪些工作需要重新確認。 因此,Harness不能只依賴模型的上下文視窗來保存資訊,而必須建立可靠的狀態管理機制,在實作的設計上,這通常包含兩個層次:
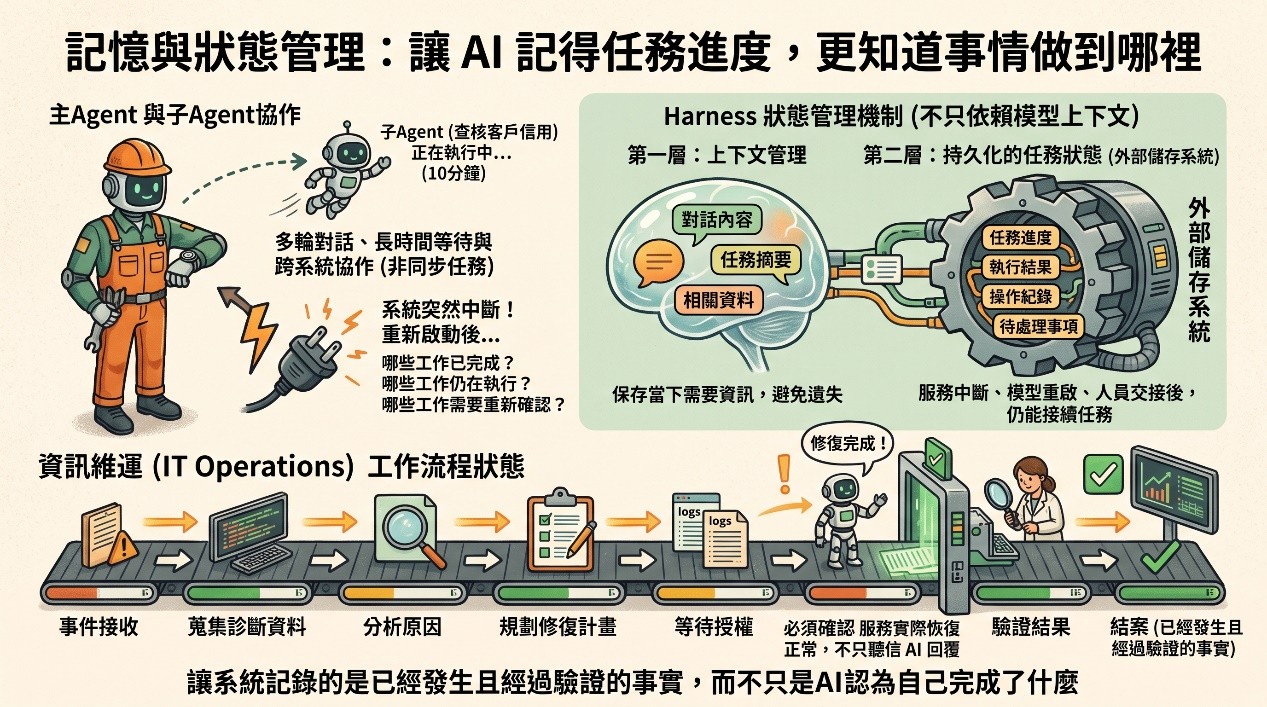 《圖說》圖片來源:AI生成示意圖-Nano Banana Pro 工具執行控制:不只讓AI能呼叫工具,更要確保工具使用安全Agent Skills的SOP主要是規範特定任務的執行方式,而到了Harness則必須進一步控制工具的使用條件、權限與執行結果;例如,AI想要重啟資料庫時,Harness不能只確認這個工具是否存在,而是必須確認:
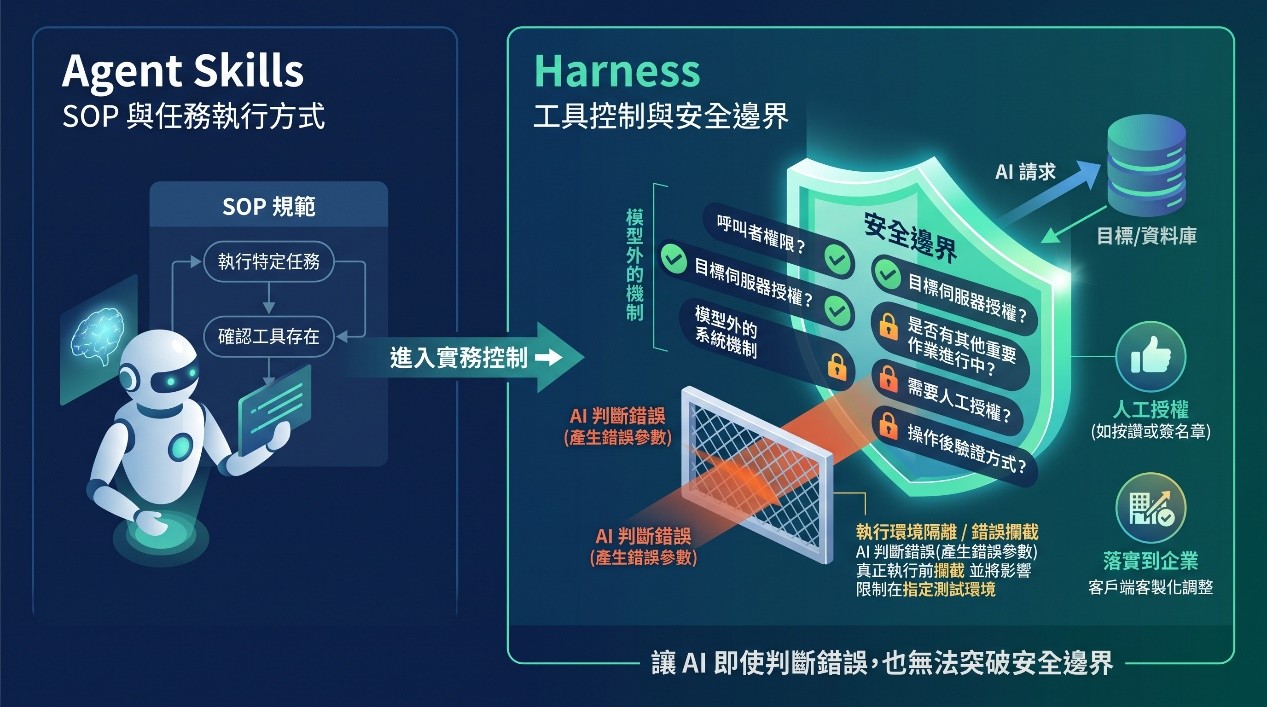 《圖說》圖片來源:AI生成示意圖-Nano Banana Pro 多Agent協作:當十幾個Agent同時工作當企業開始部署多個Agent,並讓它們分別負責不同系統或部門的工作時,問題就不再只是單一Agent的執行正確性,而是整個系統的協作與資源管理,我們假設企業部署了三個系統的維運Agent:
系統防護觀念:不是期待AI永遠不犯錯,而是要控制錯誤的影響在傳統應用程式中,Timeout、重試與錯誤處理是基本的系統設計流程。 但在AI Agent的執行環境中,模型可能自行決定工具調用順序、重複嘗試或改變原定計畫,因此系統除了需要傳統的可靠性機制,更必須具備任務狀態追蹤、行為約束與執行結果驗證能力,例如,如果API發生異常,AI可能因為過度執著於完成任務,而陷入無限重試的迴圈,短時間內大量呼叫API,導致伺服器負載升高,甚至造成服務中斷;所以Harness必須設定最大重試次數、Timeout、呼叫頻率限制、資源限制與強制中斷等機制。 而在企業環境中,還必須考慮Prompt Injection攻擊,如果Agent讀取的工單中藏有惡意指令,可能誘導它洩漏資料或呼叫未授權工具,因此外部文件與工具回傳內容不能直接被視為可信任的指令或內容。 Harness必須透過獨立的政策檢查、權限隔離與安全執行環境,確保模型即使判斷錯誤,也無法跨越系統設定的安全邊界,而在資訊業的管理中,筆者始終謹記:「即使是99%的可控性與準確性,對企業來說仍舊有1%的不可控風險」,因此系統防護觀念所需建立的核心應為:不是期待AI永遠不犯錯,而是確保它犯錯時,錯誤仍然在可控制的範圍內。讓AI能夠執行任務,只是企業駕馭工程的開始從CLI、MCP到Agent Skills,我們逐步賦予AI理解問題、呼叫工具與依照規範執行任務的能力,而當AI開始處理長時間、多步驟、跨系統的企業流程時,真正的難題就不再只是模型能不能完成工作,而是整個系統能不能在各種不確定性下持續運作。 Harness Engineering的價值,正是透過狀態管理、工具控制、權限隔離與多 Agent協作,讓AI的行動不再只是模型的一次輸出,而是能夠被追蹤、控制與驗證的系統流程。 然而,即使我們已經為 AI 建立了完整的執行框架,仍然有一個問題很難避免,那就是如果AI已經成功呼叫工具,但系統卻無法確認操作是否完成時,我們該如何確保整個流程不會因為重複執行、狀態錯亂或錯誤復原而造成更大的問題,筆者認為這是在設計Harness Engineering中最難的挑戰,特別是在團隊與企業端使用者進行需求訪談時,多數的使用者都迫不急待地要將一切交給AI去執行,甚至連最終的審核也要交給AI,這對我們在進行AI應用的開發而言,是一件極其困擾的情況,畢竟企業需要治理與可靠的執行,絕不可能完全放任AI自主執行與決策,這也是下一篇專欄要進一步探討的主題:從故障復原、可靠性驗證到企業治理,如何讓AI Agent真正具備進入正式營運環境的能力「當AI開始自主執行:Harness Engineering的可靠性與企業治理」。 |